- بازار خرس می تواند خیلی بیشتر از آنچه انتظار دارید طول بکشد
- پیمایش در انتقال دیجیتال ، حفظ یک سیستم پرداخت پایدار
- 5 موردی که باید در مورد تماس های Marrgin بدانید
- رشته های اروپایی از شکاف ارزش گذاری ایالات متحده اخلاق دارند
- ارز Tron چیست؟
- تأثیر کاهش کمی دولت بر طلا و نقره
- بیت کوین از 30 هزار دلار عبور کرد و قیمت جدیدی را برای سال 2023 تعیین کرد.
- Thinkorswim® Web
- مبدل ارز Travelex
- بهترین میانگین های متحرک برای استراتژی های معاملاتی متقاطع

آخرین مطالب
امکانات وب


مشتری ما می خواست پایه نصب شده دستگاه ها را مدل کند. برای روشن شدن ، با پایه نصب شده منظور ما تعداد دستگاه های جهان است. این مهم بود زیرا قسمت اول یک مدل بازار را تشکیل می دهد.
خرید داده هایی که تعداد دستگاه های وارد یک بازار را تخمین می زند ، بسیار آسان است. در واقع ، این فقط تعداد دستگاه های فروخته شده در هر ماه است. با این حال ، مشکل این است که ما فقط نمی توانیم تعداد دستگاه های فروخته شده را برای تخمین پایه نصب شده خلاصه کنیم. این امر به این دلیل است که مجموعه ای از دستگاه های جدید آشکارا دستگاه های بازنشسته شده را نادیده می گیرند.
دریافت تعداد دستگاه های جدید آسان است زیرا تولید کنندگان نسبتاً کمی در جهان وجود دارند. بیشتر تولید کنندگان آمار تولید خود را فاش می کنند. با این حال ، هنگام بازنشستگی ماشین ها فقط عملی نیست که گفته شود.
خوشبختانه ، ما یک روش خوب برای حل مشکل پیدا کردیم. مشتری ما به داده های تله متری تولید شده توسط دستگاه های متصل به اینترنت دسترسی داشت.
Telemetry داده هایی است که توسط یک دستگاه در هنگام کار تولید می شود. به عنوان مثال ، معمولاً در موتورها ، اتومبیل های نژاد و خطوط تولید یافت می شود.
دستگاه های رایانه ای برای درخواست به روزرسانی با سازنده خود تماس می گیرند. برای به روزرسانی مناسب ، آنها باید اطلاعاتی را ارسال کنند تا دقیقاً چه نوع سیستم را توصیف کنند. در نتیجه ، داده های مشتری ما تاریخ تولید را داشتند.
آزمایش برای دیدن اینکه آیا می توانیم از داده ها استفاده کنیم
قبل از اینکه آزمایشات خود را انجام دهیم ، یک فایل تله متری بارگذاری کردیم. این پرونده بیش از 8 گیگابایت بود. اولا ، ما برخی از آمار را ساختیم. این پرونده برای 350،000 سازمان و 16. 1 میلیون دستگاه داده داشت. در نتیجه ، ما به احتمال زیاد از نظر آماری نتایج معنی دار کسب خواهیم کرد زیرا نمونه ما بزرگ بود.
اگرچه این پرونده از نظر اندازه بسیار بزرگ بود ، تجزیه و تحلیل اولیه ما فقط به خلاصه ای از داده ها نیاز داشت.
ما با شمارش تعداد دستگاه ها بر اساس سن شروع کردیم. نتیجه فقط در حدود سی عدد است ، همانطور که در جدول در سمت راست مشاهده می کنید.
| سن در سالها | تعداد دستگاه ها | سن در سالها | تعداد دستگاه ها |
|---|---|---|---|
| <1 | 5،587 | 6 | 1،970،128 |
| 1 | 404،056 | 7 | 2،040،808 |
| 2 | 866،026 | 8 | 1،448،587 |
| 3 | 1،274،588 | 9 | 1،119،827 |
| 4 | 1،943،260 | 10 | 851،860 |
| 5 | 2،279،509 | >10 | …. |
تجسم و پردازش قدرت
واضح است که تجسم داده ها در نمودار ستون Power BI برای ما بسیار ساده است:
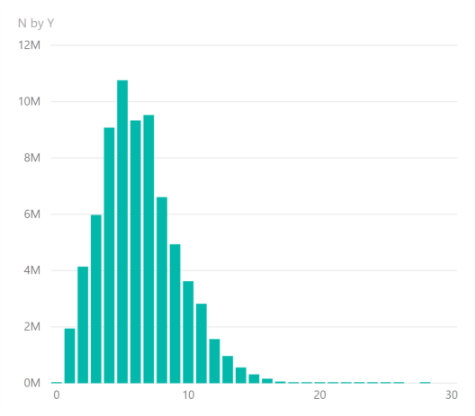
این کاملاً به ما می گوید اما می توانیم چیزهای بیشتری را کشف کنیم. به عنوان مثال ، بلافاصله مشخص نیست که میانگین سن یک دستگاه از این نمودار چیست. علاوه بر این ، ما نمی توانیم به سرعت بگوییم که چه نسبت دستگاه ها پس از چند سال باقی مانده است.
منحنی های مرگ و میر: هدف ما تشکیل یک چگالی احتمال و توزیع تجمعی برای نشان دادن داده ها به عنوان منحنی مرگ و میر بود. تبدیل مشاهدات تجربی به این قالب ها با استفاده از توزیع Weibull ساده است. این توزیع آماری معمولاً برای مدل سازی بقا در زیست شناسی و میزان شکست در مهندسی استفاده می شود. ما فکر کردیم که آموزنده است که ببینیم مشاهدات تجربی ما چقدر با توزیع مطابقت دارد.
توزیع Weibull
مشاهدات ما را به عنوان مجموعه x_t در نظر بگیرید که 1 leqslant t leqslant T .
در ابتدا، ما می توانیم تعداد دستگاه ها را به احتمالات تبدیل کنیم:
ثانیا، احتمالات را می توان به یک توزیع تجمعی تجربی تبدیل کرد:
F(t) = sum_^t p_i برای tin
تابع توزیع تجمعی وایبول (که پیوسته است) است
f(x)= 1 - e^<(x/lambda)^kappa>برای مقادیر x geqslant 0 .
در نهایت با گرفتن لگاریتم می بینیم:
ln(1-f(x)) = - (x/lambda)^kappa ln(-ln(1-f(x))) = kappa (ln(x / lambda)
ln(-ln(1-f(x)))=kappa ln(x) -kappa ln(lambda) که در قالب یک معادله خطی y'=kappa x' + c است.
بنابراین، برای اینکه ببینیم داده های تجربی ما چقدر با توزیع وایبول منطبق است، داده هایمان را برای محاسبه F'(t) = ln(-ln(1-F(t))) و t'=ln(t) تبدیل می کنیم و این نقاط را رسم می کنیم. بر روی نمودار پراکندگی
شما می توانید این را در سمت راست ببینید.
https://en. wikipedia. org/wiki/Weibull_distribution
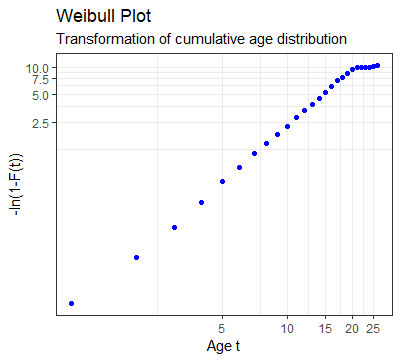
واضح است که مشاهدات یک الگوی خطی را نشان می دهند تا زمانی که به رایانه های شخصی با قدمت بیش از 20 سال برسیم.
با این حال، تا 20 سال، تابع تجمعی در حال حاضر در 99. 99٪ است و بنابراین این چند مشاهدات آخر را می توان نادیده گرفت.
از نمودار پراکندگی ما ساده است که یک خط رگرسیون خطی را به داده ها برازش کنیم. ما تناسب (از r^2)، شیب و فاصله را محاسبه می کنیم.
شیب kappa (پارامتر شکل Weibull) را به ما می دهد و از وقفه می توانیم lambda (پارامتر مقیاس Weibull) را محاسبه کنیم.
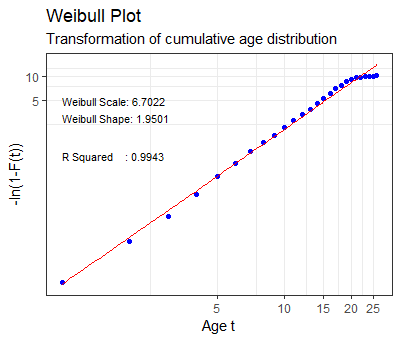
واضح است که می بینیم که r^2 به ویژه خوب است، اما اگر 0. 001٪ از نمونه بالای 20 سال را نادیده می گرفتیم، حتی بهتر بود.
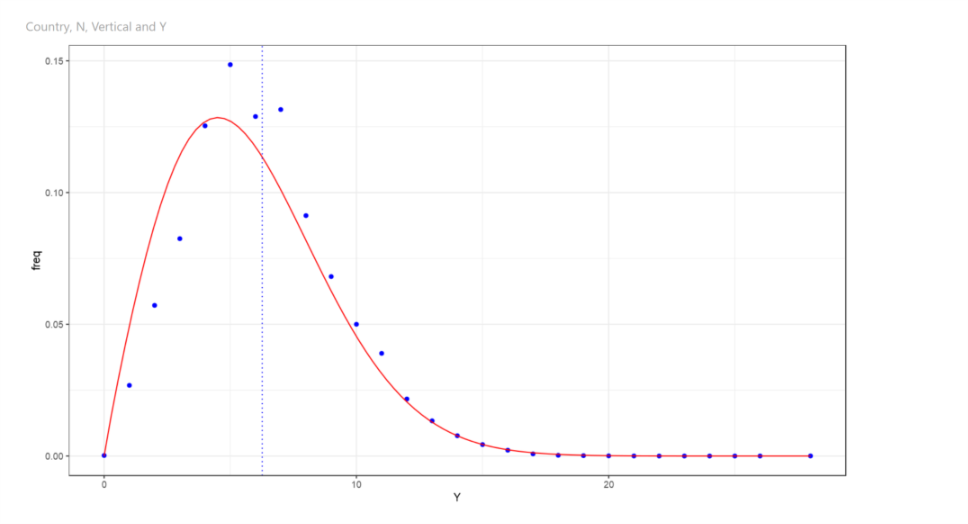
منحنی چگالی احتمال
منحنی چگالی احتمال تابعی است که مقدار آن در هر نقطه معین احتمال نسبی را فراهم می کند که مقدار متغیر تصادفی برابر با آن نمونه باشد.
نقاط آبی مقادیر داده های مشاهده شده را نشان می دهد و خط قرمز پیوسته تابعی است که ما به دست آورده ایم.
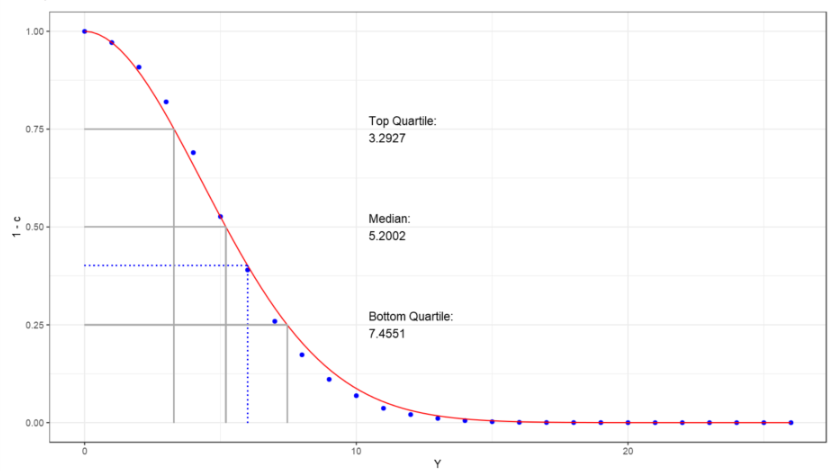
منحنی توزیع تجمعی
منحنی توزیع تجمعی یک متغیر تصادفی احتمال این است که متغیر مقداری کمتر یا مساوی x بگیرد.
این منطقه را در زیر منحنی چگالی احتمال از منهای بی نهایت تا x می دهد.
کنار هم قرار دادن
توزیع Weibull از تناسب بسیار خوبی برخوردار است. ما منحنی را برای کل جمعیت دستگاه ها به عنوان اثبات مفهوم محاسبه کردیم. با این حال ، محاسبه منحنی برای زیر مجموعه های داده ها آسان است. به عنوان مثال ، ما فهمیدیم که کشورهای مختلف طول عمر متفاوتی برای دستگاه ها دارند. ما همچنین فهمیدیم که صنایع مختلف دارای طول عمر متفاوتی هستند.
یکی از مزایای اصلی تجزیه و تحلیل ما این بود که ما توانستیم تخمین مشاغل از متوسط زندگی را که کاملاً نادرست بود به چالش بکشیم.
با گرفتن هزاران منحنی بقا و داده های حمل و نقل روکش ، مبنای خوبی برای ایجاد یک مدل بازار قوی در مقایسه با مدل های قبلی داشتیم.
مطالعات موردی مرتبط
یک معماری علوم داده
این مطالعه موردی معماری را که برای مشتری ایجاد کرده ایم توصیف می کند و مایل به کسب بیشترین استفاده از داده ها است. آنها هم داده های داخلی و هم خارجی داشتند و همچنین می خواستند با بینش بسیاری از منابع مختلف ازدواج کنند.
پذیرش تله متری
چگونه ما به یک تیم تحقیقاتی بازار کمک می کنیم تا تجزیه و تحلیل داده های تله متری را آغاز کنیم و از تغییرات بزرگ فرهنگی مورد نیاز برای اتخاذ داده های بزرگ استفاده کنیم.
فارکس پرشین...
ما را در سایت فارکس پرشین دنبال می کنید
برچسب :
نویسنده : الیزابت امینی
بازدید : <-PostHit->
آرشیو مطالب
خبرنامه
